论文主旨
WWW 2026:为 LLM Agent 设计同时衡量步骤长期价值与局部进展的过程奖励模型。
当 Agent 在网页、游戏或工具环境中执行多步任务时,单个动作往往没有明确的对错标签。一个动作可能暂时偏离目标,却是后续成功的必要准备;另一个动作看起来接近目标,却可能把系统带入死路。只在任务结束后判断成功与否(ORM),又无法指出中间每一步的价值。
论文提出 AgentPRM,将每个状态-动作的价值拆成两种互补视角:
- Promise(未来潜力):采取这一步之后,最终完成任务的可能性有多大?
- Progress(过程进展):这一步相对前一步,是否带来了价值上的改善?
模型通过 TD(Temporal Difference)+ GAE(Generalized Advantage Estimation) 从采样到的轨迹中自动估计逐步训练目标,避免为轨迹中的每个中间状态都额外执行大量 rollout。训练好的 AgentPRM 可用于 Best-of-N 重排序、逐步 Beam Search,也可以作为 PPO 强化学习的奖励模型。
研究动机:为什么 Agent 需要不同的过程奖励?
1. Agent 的动作没有简单的“正确/错误”
在数学推理中,一步计算通常能被直接判断对错。但在网页导航或工具使用中,动作的意义依赖上下文和后续状态。例如,进入登录页面看起来暂时离开了商品页面,却可能是完成购买前必须做的准备。
2. 只看最终结果,难以给中间步骤提供反馈
Outcome Reward Model(ORM)给整条轨迹打分,适合做事后筛选,但它不清楚失败由哪个动作造成,也不便于在执行中指导搜索。
3. 只估计单步价值,容易忽略步骤间的依赖
Process Value Model(PVM)为步骤预测价值,但如果只关注每一步的未来成功潜力,模型可能过度偏向眼前看起来最有希望的动作,忽视必要的探索或准备步骤。Agent 的决策是连续的:前一步会改变后续可选动作和任务成功机会。
因此论文提出两个问题:
- 怎样定义适用于 Agent 的逐步奖励?
- 怎样以较低成本、较稳定地得到逐步训练标签?
创新点
- 重新定义 Agent 的过程奖励:将动作的长期成功潜力(Promise)与相邻步骤的价值变化(Progress)一起纳入训练目标。
- 以 advantage 约束进展:不只拟合每一步的 Q-value,还拟合相邻步骤之间的 Q-value 差,让模型学习过程中的改善或退步。
- 用 TD + GAE 自动估计训练目标:复用采样轨迹和当前模型预测,不必从每个中间状态反复独立 rollout。
- 覆盖多种推理时和训练时用途:在 Best-of-N、step-level beam search、PPO 强化学习中评估,并扩展到数学推理任务。
- 报告较好的采样效率和扩展趋势:论文称 AgentPRM 在三个 Agent 任务上的平均计算效率约为基线的 8 倍;TD 标注在 WebShop、BabyAI、数学任务上的 token 成本分别为 MC 方法的约 (1/1.9)、(1/2.8)、(1/1.5)。这些数字来自论文特定实验设置,不应直接视为所有任务上的固定比例。
方法流程
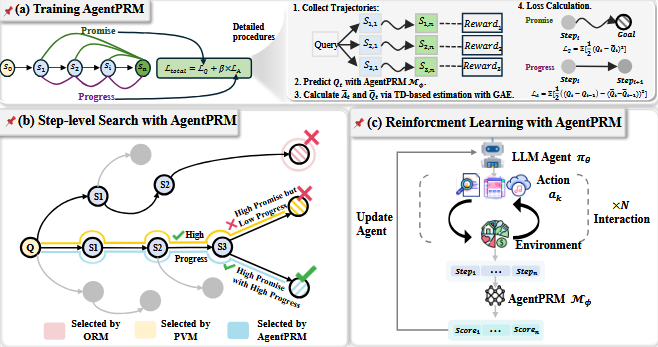
用 Agent 策略采样多步交互轨迹
             ↓
AgentPRM 为每个状态-动作预测 Q-value(Promise)
             ↓
TD residual + GAE 估计逐步 advantage 与 Q-value 目标
             ↓
Q-value 拟合损失 + 相邻步骤差分损失(Progress)
             ↓
训练好的 AgentPRM 用于重排序、Beam Search 或 PPO
方法一:用 Q-value 表示 Promise
论文将 Agent 任务建模为部分可观测决策过程。令 (s_t) 为当前交互状态,(a_t) 为 Agent 在该状态采取的动作,(pi) 为后续策略,整条轨迹的最终任务奖励为 r(u,τ)。动作价值定义为:
如果成功奖励为 1、失败奖励为 0,那么它可以理解为:**在状态 (s_t) 采取动作 (a_t),之后继续按策略行动,最终成功的期望概率。**这就是论文中的 Promise。
状态价值则是当前状态下,按策略选择动作时的平均动作价值:
AgentPRM (M_ϕ) 输入状态-动作对并预测其 Q-value。对估计目标 ,使用均方误差训练:
Q-value 判断采取该动作后,未来完成任务的机会有多大。
方法二:用 Advantage 表示 Progress
Advantage 的含义
强化学习中的优势函数定义为:
它比较当前动作与当前状态下的平均水平:
- (A>0):该动作比当前状态下的平均动作更有价值;
- (A<0):该动作相对较差;
- (A\approx0):它大致处于平均水平。
因此,Q-value 回答“未来成功的潜力有多大”,advantage 回答“当前动作相对当前状态的基准有多大优势”。
从 Advantage 到相邻步骤价值差
论文讨论的是奖励稀疏、状态转移确定的 Agent 环境。在这一设定下,它将 advantage 与相邻动作价值变化联系起来:
也就是说,如果当前步骤的价值高于前一步,模型就应学到正向进展;如果价值下降,则应反映为负向变化。论文不是简单地输出两个互不相关的“promise 分数”和“progress 分数”,而是用额外损失约束模型预测的相邻 Q-value 差。
对应的 Progress 损失为:
最终训练目标是:
其中 控制两项损失的相对权重。论文实验使用 。
| 损失项 | 约束内容 | 对应直觉 |
|---|---|---|
| 每一步预测的绝对价值接近目标 Q-value | 这一步之后有多大希望成功? | |
| 相邻步骤预测的价值差接近目标差值 | 这一步比前一步改善了多少? |
Progress 信号使模型注意到动作之间的相对变化,降低只追逐眼前高价值动作、忽略必要探索步骤的倾向。
方法三:训练目标如何产生?
Monte Carlo 方法的成本
传统 MC 标注通常先采样种子轨迹,再从其中每个动作之后的状态额外采样多条后续轨迹。如果某动作之后的 rollout 有成功轨迹,就把该动作的 Q-value 目标设为 1,否则设为 0:
这种方法的标签直观,但每个中间步骤都可能需要额外探索,计算成本高;二值成功/失败标签也可能有较高方差。
TD residual:利用相邻价值估计
AgentPRM 使用 TD residual 将即时奖励和相邻步骤的价值预测联系起来。按常见的“当前状态到下一状态”索引写法:
其中:
- rt:第 (t) 步即时奖励;论文任务通常只有终止时才有奖励;
- :折扣因子;
- Mϕ:当前 AgentPRM 的价值预测。
论文原文按相邻步骤的动作价值对编号,公式表达的是同一类 TD 差值:利用奖励和后续价值估计,衡量实际结果相对当前价值预测的偏差。
GAE:整合多个未来 TD 信号
单个 TD residual 只反映局部一步。GAE 将后续多个 residual 加权累加,估计每一步的 advantage:
控制纳入多远的未来信号:较小值更依赖局部信息,通常方差较低但偏差可能较大;较大值纳入更多远期信号,可能减少偏差但增加方差。论文实验使用 。
从 Advantage 构造 Q-value 目标
非终止步骤中,论文通过下式构造 Q-value 监督目标:
论文在其相邻步骤设定中,用前一动作的模型价值预测近似该基线,因此写成:
终止步骤直接使用环境给出的最终奖励:
这样,轨迹最终是否成功会通过 TD 和 GAE 的信号影响更早步骤的训练目标,而无需在每个中间状态重新做大量 MC rollout。
TD + GAE 与 MC 的区别
| 方法 | 怎样产生步骤标签 | 主要成本或特点 |
|---|---|---|
| MC | 从许多中间状态分别进行后续 rollout | 采样开销高;直接观察成功与否 |
| TD + GAE | 利用已采样轨迹、环境奖励和当前模型的价值预测 | 无须为每一步独立 rollout;标签依赖模型估值,存在自举误差可能 |
TD + GAE 并不意味着完全没有误差:它使用当前模型预测构造目标,预测偏差可能进入后续训练。论文的实验显示,在其任务和设置下,该方案用更少 token 得到了更好的结果。
完整训练流程
论文 Appendix D 的 Algorithm 1 可概括为:
- 采集轨迹:对每个任务初始状态,用 Agent 策略 采样完整交互轨迹。论文 TD 设置为每个 query 采样 16 条轨迹。
- 预测价值:AgentPRM 对每条轨迹中的各个状态-动作对预测 。
- 估计 advantage:用 TD residual 和 GAE 计算每一步的 。
- 生成 Q-value 目标:非终止步骤利用 advantage 与价值基线构造 ,终止步骤直接使用环境奖励。
- 计算联合损失:计算 。
- 更新 AgentPRM:反向传播更新模型参数,重复训练。
需要区分两个模型的职责:**Agent 策略 负责产生动作和轨迹;AgentPRM 负责评估每一步的价值。**论文方法的主要训练对象是 PRM,不等于训练策略本身。
训练完成后如何使用?
Best-of-N:给完整轨迹排序
- Agent 采样 (N) 条完整轨迹;
- AgentPRM 为每条轨迹的步骤估值;
- 以终止步骤分数代表轨迹质量;
- 选择分数最高的轨迹。
Step-level Beam Search:边走边筛选
- 对 beam 中的状态扩展多个候选动作;
- 对扩展后的候选步骤使用 AgentPRM 评分;
- 保留得分最高的候选路径;
- 继续扩展,直到任务终止或达到最大交互步数。
与 Best-of-N 相比,Beam Search 在每个中间步骤都使用奖励模型筛选,AgentPRM 因而能够直接影响搜索路径。
接入 PPO 强化学习
论文在 BabyAI 和 TextCraft 上将 AgentPRM 接入 PPO。附录说明,PRM-based RL 使用奖励模型在轨迹最终步骤的预测分数作为轨迹奖励。实验中的 PPO 设置包括 batch size 16、学习率 、KL 系数 ,采样温度 1.0。
实验结果
任务和模型
主要 Agent 任务包括:
- WebShop:在模拟电商网站中浏览、筛选和购买商品,最多交互 6 轮;
- BabyAI:在网格世界中根据语言指令移动、取物、开门等,最多 20 轮;
- TextCraft:收集资源并根据配方合成目标物品,最多 20 轮。
论文使用 Qwen2.5-0.5B、Qwen2.5-3B、Qwen2.5-7B 和 Llama3.1-8B 等模型。奖励模型基线主要包括 ORM 和 PVM,也比较 SFT、RFT 等训练方法。
Best-of-N 与 Beam Search
论文报告 AgentPRM 在多数设置下优于 ORM 和 PVM,并且随着推理采样预算增加,性能提升趋势更稳定。以 Qwen2.5-3B 的 WebShop beam search 为例:
| 方法 | |||
|---|---|---|---|
| ORM | 51.0 | 59.0 | 57.0 |
| PVM | 50.5 | 59.0 | 54.5 |
| AgentPRM | 61.0 | 72.5 | 76.0 |
该例中,AgentPRM 在更大的搜索预算下仍继续提升,而 ORM、PVM 在该任务上的高预算表现出现瓶颈或回落。论文汇总三个 Agent 任务后,报告 AgentPRM 平均约有 8 倍的计算效率优势;这一结论是基于论文所用采样和评测设置的平均比较。
去掉 Progress 损失的消融
论文移除 后,WebShop 上的 Best-of-N 和 Beam Search 表现均下降。这支持了 Progress loss 的作用:只拟合每一步的价值,不如同时约束相邻步骤的价值变化。
TD + GAE 的采样效率
论文将训练标签使用的 token 成本归一化为 TD-based = 1.0:
| 任务 | MC-based 成本 | TD-based 成本 |
|---|---|---|
| WebShop | 1.9× | 1.0× |
| BabyAI | 2.8× | 1.0× |
| 数学推理 | 1.5× | 1.0× |
在这张表的 Best-of-N 和 beam search 指标中,TD-based 方法也取得更高或相当的结果。例如 WebShop 的 beam search,MC-based 在 、 下为 67.5、70.5;TD-based 为 72.5、76.0。
数学推理与强化学习
论文把数学推理中的部分解看作状态、下一段推理文本看作动作,并在 GSM8K 上测试。AgentPRM 在 Best-of-N 和 Beam Search 中整体优于 ORM/PVM,说明其方法也可用于逐步生成任务。
在 BabyAI 和 TextCraft 的 PPO 实验中,论文观察到 AgentPRM 的训练曲线比基线更稳定、提升更有效。论文还在 Qwen2.5-7B 和 Llama3.1-8B 上验证了方法,报告 AgentPRM 相比 ORM/PVM 保持优势。
方法的边界与局限
- 依赖任务奖励和轨迹质量:TD + GAE 的目标来自采样轨迹、终止奖励和当前模型预测。如果采样策略很少探索到成功路径,正向监督信号可能不足。
- 存在自举误差:TD 目标使用当前 AgentPRM 的预测;模型估值不准时,误差可能传入训练标签。论文在实验中取得良好结果,但没有消除这一风险。
- 理论直觉依赖任务设定:论文对相邻 Q-value 差与 advantage 的联系建立在稀疏奖励、确定性转移等设定上。随机性更强、奖励更密集的环境可能需要调整估计方式。
- 长程任务的泛化仍待验证:主要 Agent 基准的最大交互长度为 6 或 20 步,不能据此断定它在非常长、复杂的真实工具链中同样稳定。
- 计算效率数字依赖评测口径:论文的约 8× 是在所比较任务和采样预算下的汇总结论,不应被解释成任意部署环境中的固定墙钟加速比。
- Progress 是价值变化监督,不是完备的因果归因:相邻价值差能提供进展信号,但并不自动证明某一步是成功或失败的唯一原因。
总结
AgentPRM 的核心不只是“给每个动作打分”,而是用两种训练约束让逐步价值更适合 Agent 决策:
- Q-value 拟合:估计当前动作之后的长期成功潜力(Promise);
- Advantage 差分拟合:学习当前动作相对前一步的价值变化(Progress);
- TD + GAE 标签估计:沿已有轨迹传播终局结果,减少逐状态 MC rollout 的成本。