论文主旨
ICLR2026 解决LLM多智能体系统中的故障归因问题
当复杂的多智能体系统(如 MetaGPT、AutoGen 等)在执行任务失败时,系统往往会生成一条冗长复杂的执行轨迹。人工排查错误步骤和责任Agent犹如大海捞针。本论文提出了 AgentTracer 自动化数据构建框架和 AgentTracer-8B 轻量级故障追踪模型,旨在自动、精准地定位导致系统失败的责任智能体及决定性错误步骤,并提供可操作的反馈以提升系统性能。
-
多智能体系统极其脆弱:虽然多模型协作、复杂工具调用让 LLM 变得更强大,但也放大了系统的脆弱性
-
现有大模型故障归因能力弱:即使强如 OpenAI-o1、DeepSeek-R1,在现有的故障归因测试中,准确率也惨不忍睹(通常低于 10%)
-
数据集与方法存在空白:现有的故障归因数据集(如 MAST、Who&When)规模太小,且缺乏自动化构建大规模、高质量标注数据的框架,也没有专门且高效的故障追踪模型
创新点
-
反事实重放标注真实失败轨迹: 对失败轨迹逐步尝试局部修正,并重新模拟后续过程。如果修正某一步就能使任务成功,该步就被标为决定性错误。按时间顺序搜索,可以找到最早的决定性错误
-
程序化故障注入扩充数据: 从成功轨迹中选取步骤,扰动原动作并重放。如果扰动后任务失败,注入点的智能体和步骤就能作为已知标签
-
首个自动化故障轨迹标注流水线(AgentTracer):结合了反事实重放错误轨迹和正确轨迹程序化故障注入技术,自动构建了包含2000+高质量轨迹对的 TracerTraj-2.5K数据集
-
轻量级故障追踪器(AgentTracer-8B):基于 Qwen3-8B,通过Multi-granular RL训练,在故障定位的准确率上不仅远超同量级模型,还超越了 GPT-4.1、Gemini-2.5-Pro、Claude-4-Sonnet 等闭源大模型
-
验证诊断反馈能帮助系统改进: 论文不只评估归因准确率,还把 AgenTracer 的反馈送回 MetaGPT、MaAS、OWL 等系统,能直接帮助它们进行自我反思和纠正
方法流程
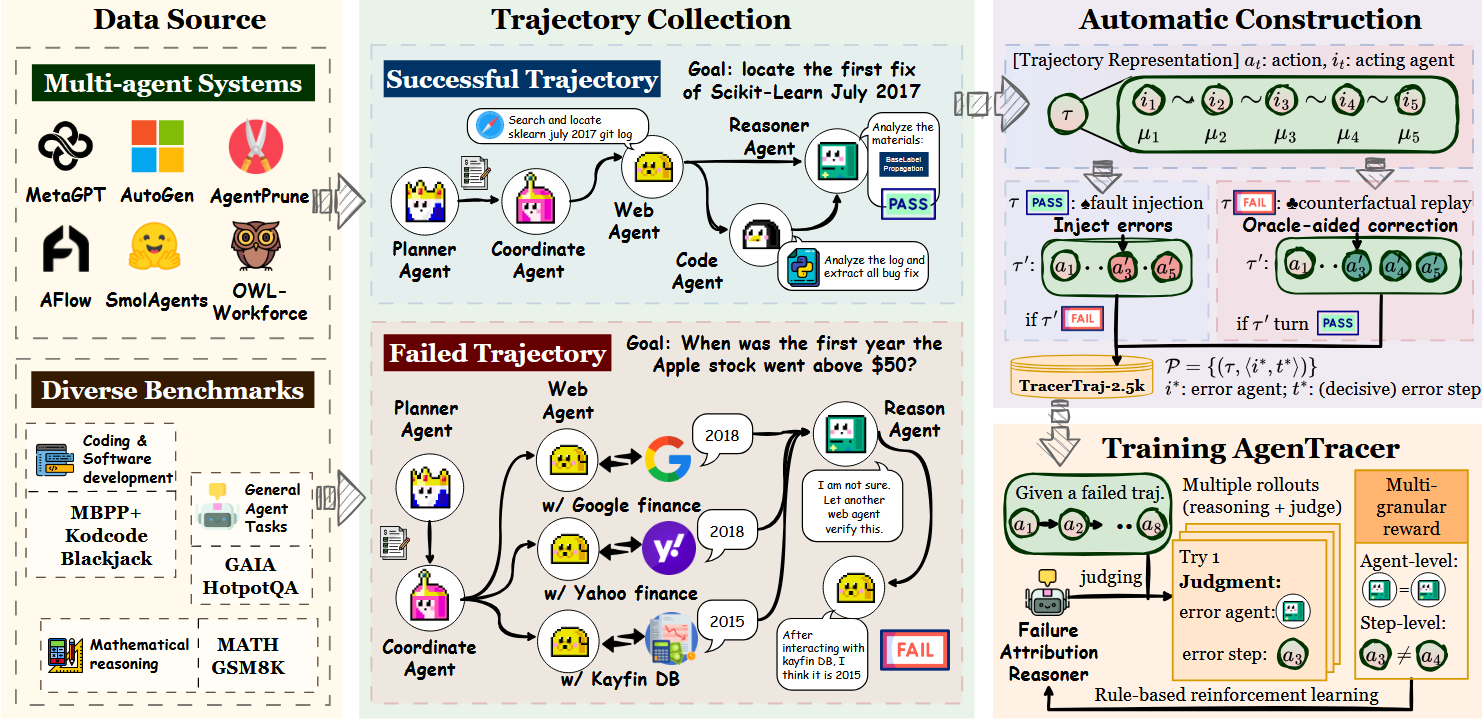
Step 1: 自动化轨迹标注 (AgentTracer)
- 收集:让 6 种不同的多智能体系统在 7 个数据集上跑任务,按成功和失败分类
- 反事实重放(针对失败轨迹):Analyzer agent 根据轨迹、环境反馈和任务答案,为某一步提出局部修正;系统替换该动作并重新运行后续过程,若任务从失败变为成功,则该步被标注为决定性错误
- 程序化故障注入(利用成功轨迹):对成功的轨迹随机挑选步骤进行人为的代码/逻辑扰动,如果导致了系统失败,那么这个注入点就是已知的decisive error
- 产出:由上述两部分生成了 TracerTraj-2.5K 训练数据集。其中,反事实修正数据更贴近原始失败,但标注质量依赖 analyzer agent;故障注入数据的标签由注入位置确定,但合成错误未必覆盖真实系统中的全部失败类型
Step 2: 强化学习训练追踪器 (AgentTracer-8B)
得到高质量数据集后,作者直接以 Qwen3-8B 为基座模型,采用 GRPO 算法进行在线强化学习训练,没有使用 SFT 冷启动。模型在试错中自行学会规定的输出格式和精准的故障定位能力。
多粒度奖励设计(Multi-Granular Reward)
对于同一条失败轨迹 ,模型会生成 个候选答案(论文中 ),第 个候选答案 (预测的智能体和步骤)的总奖励 计算公式如下:
- 格式硬门控():这是一个极其严格的 0/1 开关,如果格式不对,奖励为零
- Agent 级奖励():粗粒度得分。找对了责任智能体得 1 分,找错得 0 分
- Step 级奖励():细粒度得分。使用了高斯核函数给予部分正确分,越接近真实错误步骤,奖励越高
\mathcal{L}{\mathrm{RL}} = -\mathbb{E}{\tau ,{\hat{p}k}{k = 1}^G}\left[\frac{1}{G}\sum_{k = 1}^{G}\min (\rho_kA_k,\mathrm{clip}(\rho_k,1 - B_s,1 + B_s)A_k)\right]
- **组内相对优势计算(Advantage, $A_k$)**: 对于同一条轨迹生成的 $G$ 个候选答案,利用组内奖励进行标准化处理,得到优势函数 $A_k = \frac{R_k - \text{mean}(\{R_j\})}{\text{std}(\{R_j\}) + \epsilon}$。若 $A_k > 0$,表示该候选答案的奖励高于组内平均水平,具有正向优势;反之则具有负向优势。这种设计消除了不同任务间奖励量纲的差异,降低了方差 - **策略比率计算(Policy Ratio, $\rho_k$)**: $\rho_k$ 定义为当前正在更新的新策略($\pi_{\mathrm{tracer}}$)与采样时的旧策略($\pi_{\mathrm{old}}$)生成该候选答案的概率比值。该比率反映了模型参数更新对候选动作生成概率的影响程度 - **Clip 截断机制**: 为防止策略单次更新幅度过大导致性能坍塌,目标函数引入了 `clip` 操作,将策略比率 $\rho_k$ 强行约束在 $[1-B_s, 1+B_s]$ 区间内。结合外层的 `min` 操作,算法采取了保守更新策略:当面对正优势($A_k > 0$)的答案时,限制其概率提升的上限;当面对负优势($A_k < 0$)的答案时,限制其概率下降的下限 - **动态裁剪边界**: 裁剪参数 $B_s$ 采用随训练步数 $s$ 线性衰减的动态策略,即 $B_s = \max(0.2B_0, B_0(1 - s/S_{\mathrm{total}}))$。该设计在训练初期维持较大的边界以鼓励模型进行探索,在训练后期逐渐收窄以促进策略的稳定利用与收敛 ### Step 3: 用诊断反馈改进系统 在失败轨迹上,AgenTracer 输出责任智能体、错误步骤和解释,把这些反馈提供给原多智能体系统,继续执行后续轮次,并与 Self-Refine、CRITIC 等反思方法比较。部分系统和任务因此得到性能提升 ## 局限 - **对分析智能体(Analyzer)的能力高度依赖**:数据构建阶段(反事实重放)依赖强大的外部模型分析,如果分析者能力弱,则纠正成功率显著下降,导致高质量数据的产出受限 - **“决定性错误”的定义存在简化**:论文将错误定义为“最早被纠正后能导致成功的单点动作”,但在现实复杂的协作中,往往是多个小错误累积导致崩溃,这种单点归因可能无法完全覆盖真实世界的复杂错误模式 - **基准测试集规模限制**:模型在更庞大、更开放环境下的泛化能力仍需进一步验证。